¿Y si pudiéramos leer el periódico de dentro de un mes?

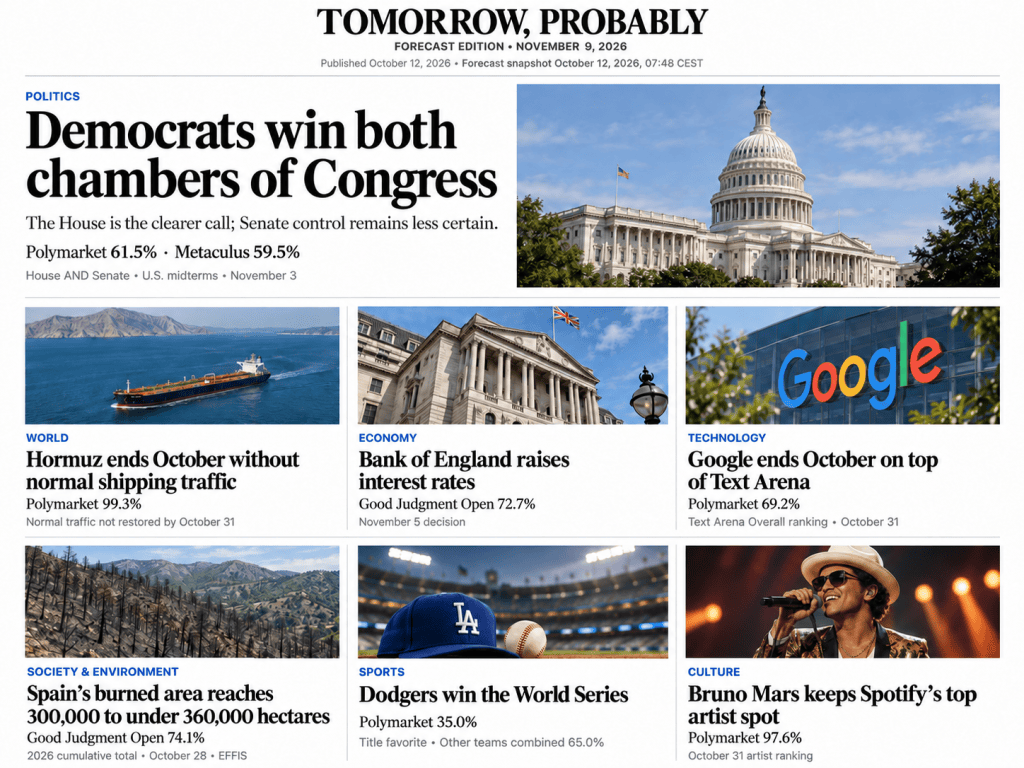
Imaginemos que hoy abrimos un periódico fechado dentro de cuatro semanas. Sus titulares hablan de unas elecciones que todavía no se han celebrado, de una decisión de un Banco Central aún pendiente, de un nuevo modelo de inteligencia artificial que todavía no se ha presentado o del equipo que podría ganar las World Series.

Evidentemente, nadie conoce esas noticias todavía. Pero eso no significa que no podamos decir nada sobre ellas. Sobre muchos acontecimientos futuros existen ya mercados de predicción, comunidades de superpronosticadores y otros sistemas que intentan estimar qué probabilidad tiene cada posible resultado.

De ahí nace este pequeño experimento.

Tomorrow, Probably

La imagen que acompaña este artículo es una primera prueba de Tomorrow, Probably, un periódico ficticio fechado cuatro semanas en el futuro.
Seguir leyendo «¿Y si pudiéramos leer el periódico de dentro de un mes?»

David Hume y la incertidumbre: ¿por qué creemos que el futuro se parecerá al pasado?

En los artículos anteriores hemos visto distintas formas de enfrentarse a la incertidumbre. Sócrates nos enseñó a reconocer nuestra ignorancia, Epicteto a aceptar lo que no controlamos, Sexto Empírico a suspender el juicio, Al-Ghazali a desconfiar de las conexiones causales aparentes, Santo Tomás de Aquino a ordenar los grados del conocimiento y Pascal a convertir parte del azar en un problema de probabilidades y decisiones.

David Hume plantea una dificultad todavía más profunda. Casi todas nuestras predicciones suponen que las regularidades observadas en el pasado continuarán en el futuro. Pero ¿qué justifica esa confianza?

Seguir leyendo «David Hume y la incertidumbre: ¿por qué creemos que el futuro se parecerá al pasado?»

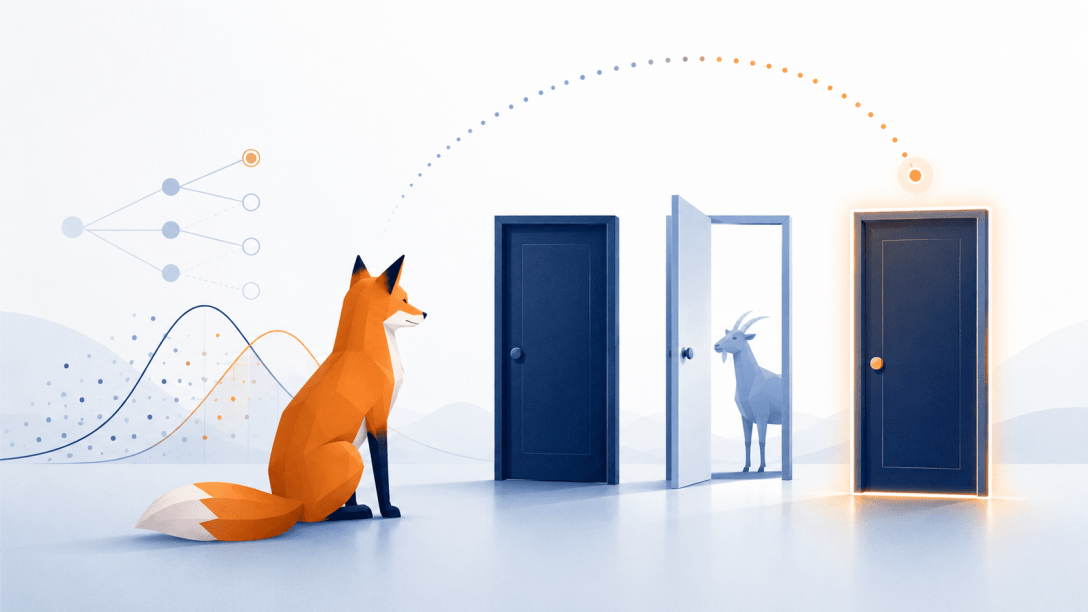
Actualizar creencias: la lección bayesiana de Monty Hall

Imagina que participas en un concurso con tres puertas. Detrás de una hay un coche y detrás de las otras dos, una cabra. Escoges una puerta, pero antes de mostrarte su contenido, el presentador abre otra y deja ver una cabra. Después te ofrece cambiar tu elección por la única puerta que continúa cerrada.

La respuesta intuitiva suele ser que da igual: quedan dos puertas y, aparentemente, cada una tiene un 50 % de probabilidades. Sin embargo, cambiar duplica las posibilidades de ganar, que pasan de 1/3 a 2/3.

El problema de Monty Hall (basado en un concurso de TV real presentado por su epónimo presentador), explicado por Charles Wheelan en Naked Statistics, no es solo un acertijo. Es una lección bayesiana sobre cómo debemos actualizar nuestras creencias cuando recibimos nueva información.

Seguir leyendo «Actualizar creencias: la lección bayesiana de Monty Hall»

Reseña del libro «Naked Statistics: Stripping the Dread from the Data»

Naked Statistics: Stripping the Dread from the Data, publicado en 2013 por Charles Wheelan, parte de una idea sencilla: para comprender la estadística no es imprescindible comenzar por las fórmulas. Antes de calcular medias, probabilidades o regresiones, conviene entender qué preguntas intentan responder estas herramientas.

El propósito del libro no es formar estadísticos, sino reducir el temor que suele provocar la estadística. Wheelan recurre a historias y ejemplos relacionados con la economía, la medicina, las encuestas, los seguros o el deporte para mostrar cómo los datos intervienen constantemente en nuestras decisiones.

A lo largo de trece capítulos, el libro avanza desde la estadística descriptiva hasta la probabilidad, el muestreo, la inferencia, la regresión y la causalidad. Su argumento central es que una cifra puede ser matemáticamente correcta y, aun así, ofrecer una representación engañosa de la realidad.

Seguir leyendo «Reseña del libro «Naked Statistics: Stripping the Dread from the Data»»

Al-Ghazali y la incertidumbre: ¿podemos confiar en las causas?

En los artículos anteriores hemos visto distintas formas de enfrentarse a la incertidumbre. Sócrates nos enseñó a reconocer nuestra ignorancia, Epicteto a aceptar lo que no controlamos y Sexto Empírico a suspender el juicio cuando faltan razones suficientes.

Al-Ghazali introduce una nueva pregunta, especialmente relevante para la predicción: cuando observamos que dos acontecimientos se repiten juntos, ¿podemos afirmar que uno causa necesariamente el otro?

Seguir leyendo «Al-Ghazali y la incertidumbre: ¿podemos confiar en las causas?»

Sócrates y la incertidumbre: el valor de saber que no sabemos

La incertidumbre no nació con la estadística moderna ni con la teoría de la probabilidad. Mucho antes de medir el azar con números, los seres humanos ya tenían que tomar decisiones, defender ideas y elegir caminos sin disponer de certezas completas. La filosofía nació, en parte, para enfrentarse a preguntas difíciles y universales como estas: qué podemos conocer, cómo debemos actuar y cómo convivir con la incertidumbre.

Con este artículo comenzamos una nueva serie dedicada a explorar cómo distintos filósofos han reflexionado sobre la incertidumbre y qué podemos aprender de ellos para mejorar nuestras predicciones y decisiones. Empezaremos por uno de los más influyentes: Sócrates.

Seguir leyendo «Sócrates y la incertidumbre: el valor de saber que no sabemos»

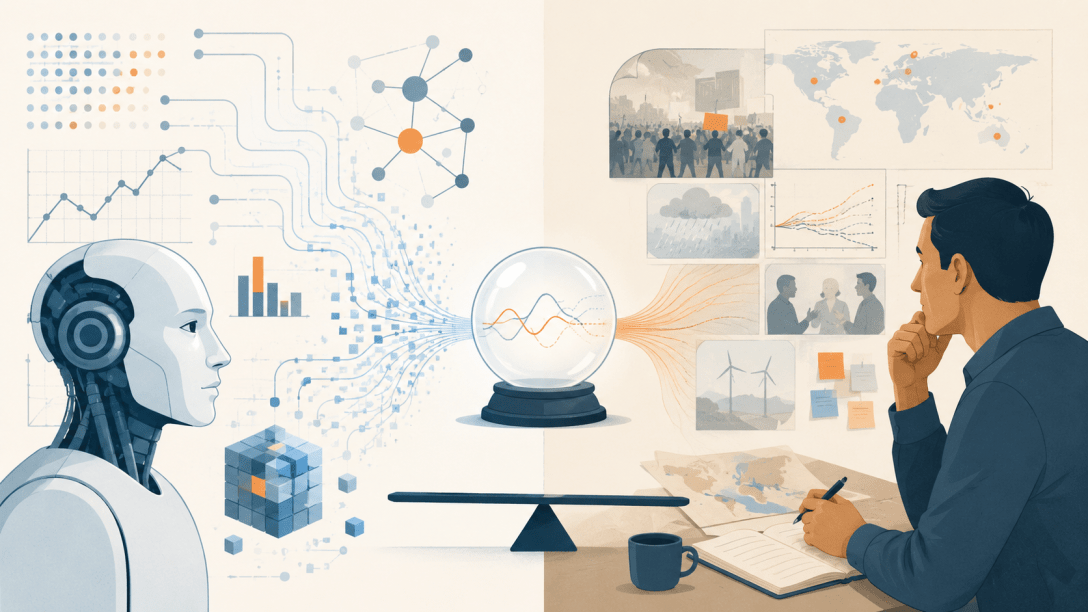
Machine Learning vs. superforecasters: quién gana depende de la pregunta

Como ya vimos en el post sobre el mapa de métodos de previsión, no todas las predicciones pertenecen a la misma familia. El método adecuado depende mucho del tipo de problema que queremos anticipar: no es lo mismo prever una serie mensual de ventas, estimar el gasto de personal de una organización o asignar una probabilidad a un acontecimiento político.

Por eso resulta útil una distinción propuesta recientemente en el debate sobre ForecastBench: la diferencia entre dataset questions y market questions. Dicho de forma sencilla: hay preguntas que se parecen mucho a un problema de datos y otras que se parecen más a un problema de juicio.

Seguir leyendo «Machine Learning vs. superforecasters: quién gana depende de la pregunta»

Ernst Bloch y la predicción: el “todavía-no” del futuro

Cuando pensamos en predicción, lo habitual es imaginar datos, modelos y probabilidades. Intentos de reducir la incertidumbre para tomar mejores decisiones. Pero hay una cuestión más profunda: ¿de dónde nace realmente esa necesidad de anticipar el futuro?

El filósofo Ernst Bloch ofrece una respuesta sugerente: el ser humano no vive solo en el presente, sino proyectado constantemente hacia lo que aún no existe. Antes de calcular escenarios, ya imaginamos posibilidades. Antes de construir modelos, ya vivimos orientados hacia el futuro.

Seguir leyendo «Ernst Bloch y la predicción: el “todavía-no” del futuro»

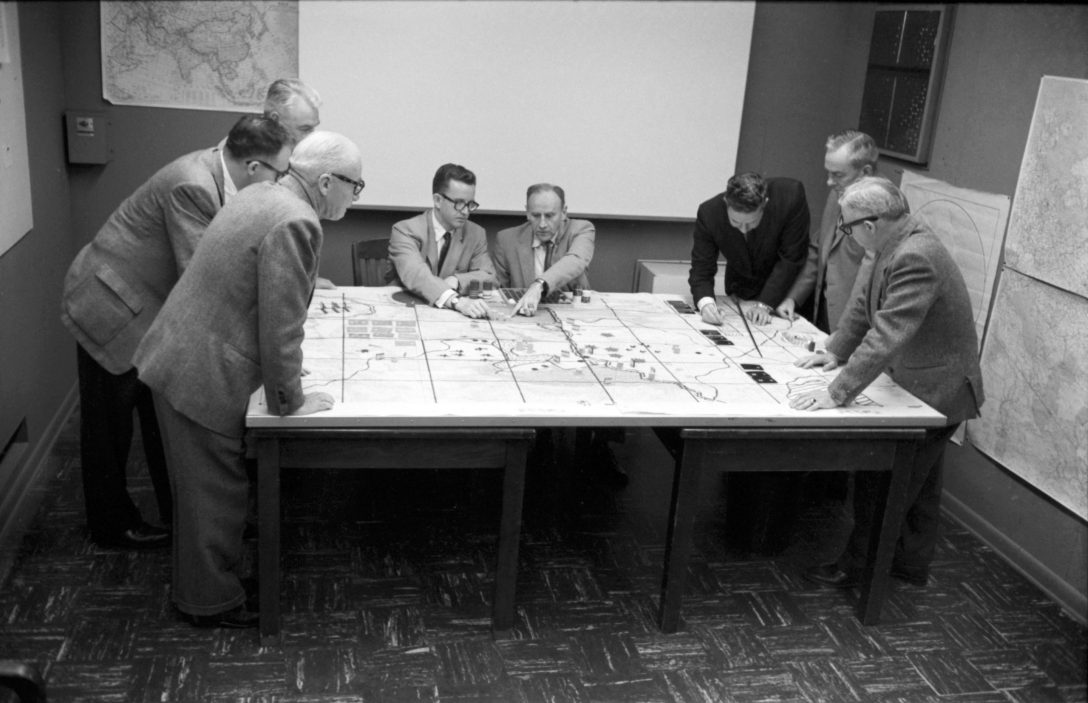
El Método Delphi: cuando la predicción cualitativa se vuelve estructurada

En un post anterior clasificábamos los métodos de previsión en dos grandes familias: cuantitativos y cualitativos. Dentro de los cualitativos podemos distinguir aquellos basados en juicio individual (opinión experta, analogías históricas, escenarios narrativos) y aquellos que intentan estructurar el juicio colectivo para reducir sesgos. El método Delphi pertene a esta segunda categoria.

No es predicción basada en datos en sentido estricto porque no parte de series temporales ni modelos matemático pero tampo es simple intuición. Es, probablemente, el intento más sofisticado del siglo XX de convertir el juicio experto en una herramienta sistemática de predicción.

Este método nació además en un contexto donde equivocarse podía significar una guerra nuclear.

Seguir leyendo «El Método Delphi: cuando la predicción cualitativa se vuelve estructurada»

Predicción cuantitativa analítica: cuándo usarla y cómo elegir modelo

En el post anterior vimos que la predicción no siempre empieza con datos y modelos: a veces lo más razonable es recurrir a estrategias cualitativas. Pero cuando el fenómeno es lo bastante estable, repetible y medible, la predicción cuantitativa ofrece algo muy valioso: un lenguaje común para comparar, evaluar y mejorar.

Ahora bien, dentro de la predicción cuantitativa conviene hacer una distinción fundamental porque no todos los modelos numéricos funcionan igual.

  • Algunos resuelven una estructura matemática estimada a partir de los datos y producen una predicción directa.
  • Otros, en cambio, recrean el sistema múltiples veces mediante simulación, generando dinámicas posibles y distribuciones emergentes.

Este post se centra en la primera familia: la predicción cuantitativa analítica.

Seguir leyendo «Predicción cuantitativa analítica: cuándo usarla y cómo elegir modelo»