
Blog sobre predicción estadística, inteligencia artificial y visualización de datos. Aprende a pensar como un zorro: con modelos flexibles, probabilidades bayesianas y sentido crítico.
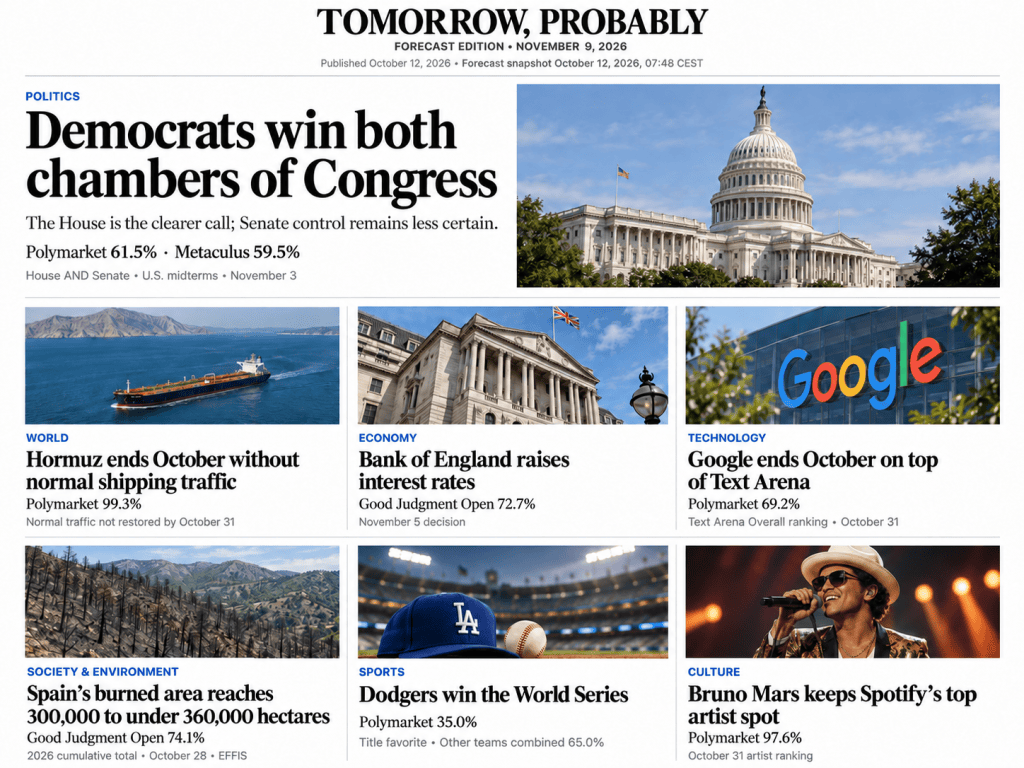
¿Y si pudiéramos leer el periódico de dentro de un mes?
Imaginemos que hoy abrimos un periódico fechado dentro de cuatro semanas. Sus titulares hablan de unas elecciones que todavía no se han celebrado, de una decisión de un Banco Central aún pendiente, de un nuevo modelo de inteligencia artificial que todavía no se ha presentado o del equipo que podría ganar las World Series.
Evidentemente, nadie conoce esas noticias todavía. Pero eso no significa que no podamos decir nada sobre ellas. Sobre muchos acontecimientos futuros existen ya mercados de predicción, comunidades de superpronosticadores y otros sistemas que intentan estimar qué probabilidad tiene cada posible resultado.
De ahí nace este pequeño experimento.
Tomorrow, Probably
La imagen que acompaña este artículo es una primera prueba de Tomorrow, Probably, un periódico ficticio fechado cuatro semanas en el futuro.
Los modelos de series temporales: cuando el orden de los datos importa
En el artículo sobre predicción cuantitativa analítica vimos que existen distintas familias de modelos capaces de transformar datos históricos en predicciones.
Los modelos de regresión, por ejemplo, intentan responder a una pregunta como: ¿de qué factores depende este resultado? Los modelos de series temporales plantean una pregunta diferente:
¿Qué patrón ha seguido esta variable a lo largo del tiempo y hasta qué punto podemos proyectarlo hacia el futuro?
La diferencia parece pequeña, pero cambia por completo la manera de analizar los datos. En una serie temporal no sólo importa el valor observado: también importa cuándo se produjo y qué ocurrió antes.
Así podemos intentar prever la demanda eléctrica de la próxima semana, las ventas del siguiente trimestre, la inflación de los próximos meses o la plantilla que necesitará una organización.
(más…)
El teorema central del límite no arregla una mala muestra
¿Cómo puede una encuesta realizada a poco más de mil personas decirnos lo que piensa todo un país? La respuesta se encuentra, en buena medida, en el teorema central del límite, una de las ideas fundamentales de la estadística.
Este teorema permite utilizar muestras relativamente pequeñas para realizar estimaciones sobre poblaciones mucho mayores. Sin embargo, su poder suele interpretarse de forma demasiado optimista: reunir muchos datos no garantiza que las conclusiones sean fiables.
En Naked Statistics, Charles Wheelan insiste en una condición esencial: la muestra debe haber sido obtenida adecuadamente. Aumentar su tamaño reduce los errores causados por el azar, pero no corrige una selección sesgada.
(más…)
David Hume y la incertidumbre: ¿por qué creemos que el futuro se parecerá al pasado?
En los artículos anteriores hemos visto distintas formas de enfrentarse a la incertidumbre. Sócrates nos enseñó a reconocer nuestra ignorancia, Epicteto a aceptar lo que no controlamos, Sexto Empírico a suspender el juicio, Al-Ghazali a desconfiar de las conexiones causales aparentes, Santo Tomás de Aquino a ordenar los grados del conocimiento y Pascal a convertir parte del azar en un problema de probabilidades y decisiones.
David Hume plantea una dificultad todavía más profunda. Casi todas nuestras predicciones suponen que las regularidades observadas en el pasado continuarán en el futuro. Pero ¿qué justifica esa confianza?
(más…)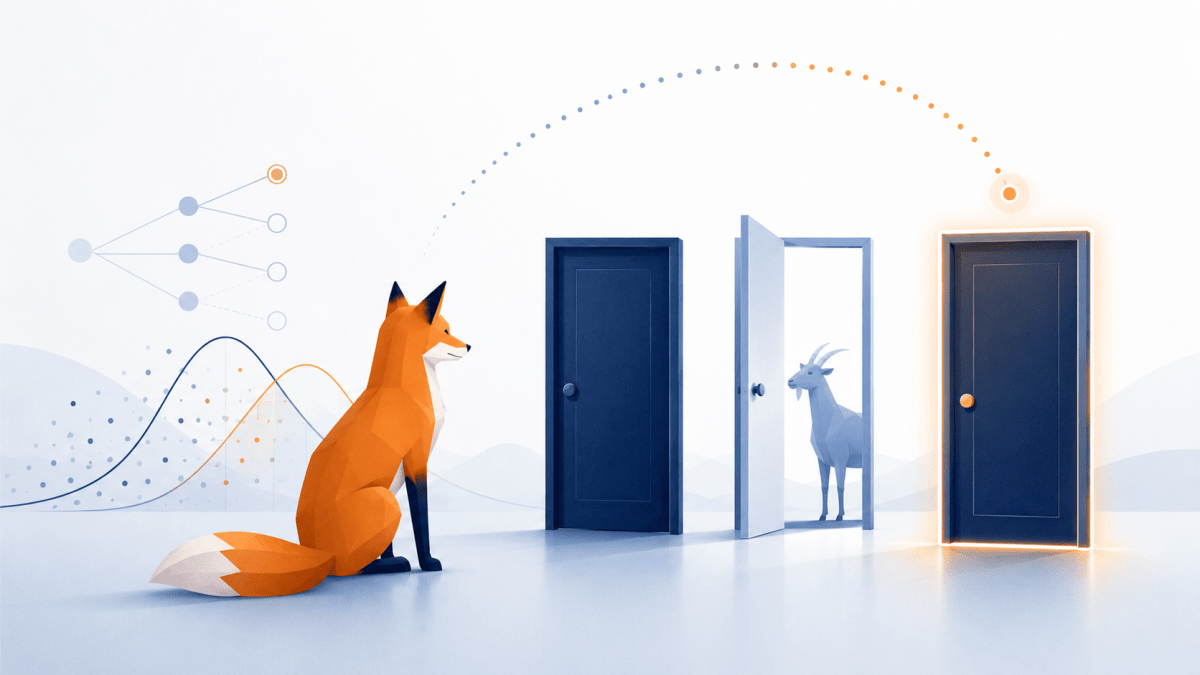
Actualizar creencias: la lección bayesiana de Monty Hall
Imagina que participas en un concurso con tres puertas. Detrás de una hay un coche y detrás de las otras dos, una cabra. Escoges una puerta, pero antes de mostrarte su contenido, el presentador abre otra y deja ver una cabra. Después te ofrece cambiar tu elección por la única puerta que continúa cerrada.
La respuesta intuitiva suele ser que da igual: quedan dos puertas y, aparentemente, cada una tiene un 50 % de probabilidades. Sin embargo, cambiar duplica las posibilidades de ganar, que pasan de 1/3 a 2/3.
El problema de Monty Hall (basado en un concurso de TV real presentado por su epónimo presentador), explicado por Charles Wheelan en Naked Statistics, no es solo un acertijo. Es una lección bayesiana sobre cómo debemos actualizar nuestras creencias cuando recibimos nueva información.
(más…)
Blaise Pascal y la incertidumbre: decidir sin tener certezas
En artículos anteriores hemos visto distintas formas de enfrentarse a la incertidumbre. Sócrates nos enseñó a reconocer nuestra ignorancia, Epicteto a aceptar lo que no controlamos, Sexto Empírico a suspender el juicio, Al-Ghazali a desconfiar de las conexiones causales aparentes y Santo Tomás de Aquino a distinguir entre diferentes grados de conocimiento.
Blaise Pascal aporta un cambio decisivo. La incertidumbre no solo puede aceptarse u ordenarse: en determinadas situaciones también puede medirse. Sin embargo, Pascal comprendió que calcular probabilidades no elimina la necesidad de decidir ni convierte la vida humana en un problema matemático perfectamente definido.
(más…)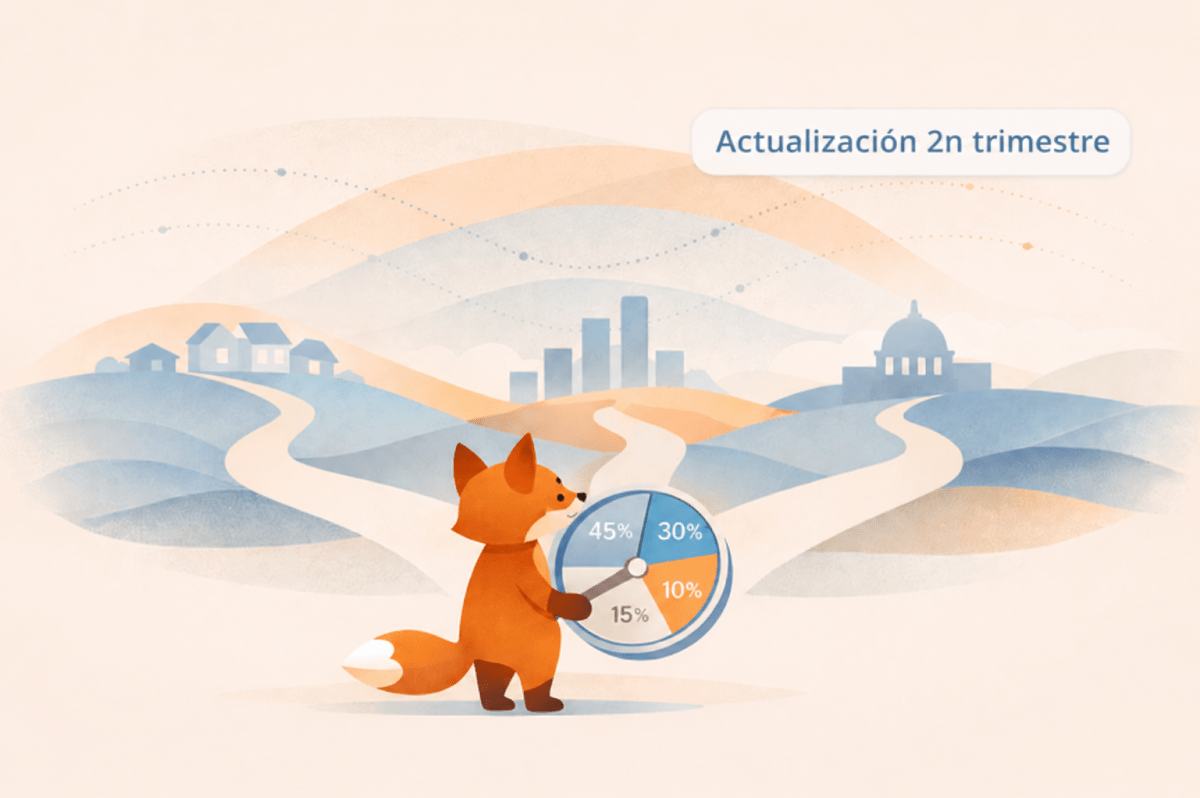
Tres predicciones para 2026 (revisión segundo trimestre)
A comienzos de año planteé tres predicciones para 2026 siguiendo un enfoque explícitamente probabilístico. El objetivo no era acertar una cifra exacta, sino dejar por escrito qué escenarios consideraba más plausibles, qué información sostenía esas estimaciones y qué hechos podrían obligarme a modificarlas.
En abril realicé una primera actualización después de que el comienzo del año alterara de forma significativa el escenario inicial. Ahora, superada la primera mitad de 2026, disponemos de nueva información sobre la inflación, el mercado inmobiliario y la situación presupuestaria.
Las tres predicciones evolucionan de manera diferente. En inflación, la nueva evidencia concentra la distribución alrededor de un escenario central más definido. En vivienda, los datos obligan a desplazarla claramente hacia valores más altos. En los Presupuestos Generales del Estado, el evento puede considerarse prácticamente resuelto.
(más…)
Cómo escoger el indicador adecuado para describir una realidad
Los datos no hablan por sí solos. Para que resulten comprensibles tenemos que resumirlos mediante indicadores: una media, una tasa, un porcentaje, una mediana o un índice. Estas cifras nos permiten comparar situaciones complejas, detectar cambios y tomar decisiones.
Pero todo resumen implica una pérdida de información. Un indicador puede ser matemáticamente correcto y, aun así, ofrecer una imagen incompleta o incluso engañosa. No porque los datos sean falsos, sino porque la cifra elegida destaca una parte de la realidad y oculta otras.
Esta es una de las primeras lecciones de Naked Statistics: antes de interpretar un indicador debemos preguntarnos qué mide exactamente, qué información deja fuera y si responde realmente a la pregunta que queremos resolver.
(más…)
Santo Tomás de Aquino y la incertidumbre: ordenar lo que podemos saber
En los artículos anteriores hemos visto distintas maneras de enfrentarse a la incertidumbre. Sócrates nos enseñó a reconocer nuestra ignorancia, Epicteto a aceptar lo que no controlamos, Sexto Empírico a suspender el juicio y Al-Ghazali a desconfiar de las conexiones causales que creemos observar.
Santo Tomás de Aquino aporta otra respuesta: no todo lo que creemos se sostiene con el mismo grado de certeza. Algunas afirmaciones pueden demostrarse, otras solo resultan probables y otras quedan fuera del alcance de la razón humana. Gestionar la incertidumbre consiste, en buena medida, en aprender a distinguirlas.
(más…)
Reseña del libro «Naked Statistics: Stripping the Dread from the Data»
Naked Statistics: Stripping the Dread from the Data, publicado en 2013 por Charles Wheelan, parte de una idea sencilla: para comprender la estadística no es imprescindible comenzar por las fórmulas. Antes de calcular medias, probabilidades o regresiones, conviene entender qué preguntas intentan responder estas herramientas.
El propósito del libro no es formar estadísticos, sino reducir el temor que suele provocar la estadística. Wheelan recurre a historias y ejemplos relacionados con la economía, la medicina, las encuestas, los seguros o el deporte para mostrar cómo los datos intervienen constantemente en nuestras decisiones.
A lo largo de trece capítulos, el libro avanza desde la estadística descriptiva hasta la probabilidad, el muestreo, la inferencia, la regresión y la causalidad. Su argumento central es que una cifra puede ser matemáticamente correcta y, aun así, ofrecer una representación engañosa de la realidad.
(más…)Se ha producido un error. Actualiza la página y/o inténtalo de nuevo.

