Proyecto de regresión lineal simple para estimar el efecto del absentismo laboral sobre la contratación temporal

En este post comparto el README del proyecto “Absentismo IT → contratos temporales de cobertura”, en el que se desarrolla un modelo de regresión lineal simple para estimar la relación entre absentismo laboral y contratación temporal.

👉 Puedes acceder al repositorio completo aquí: [enlace a GitHub]

A continuación se muestra el contenido completo del README tal y como está publicado en el repositorio.

Este repositorio muestra un proyecto completo de análisis de datos orientado a responder una pregunta muy concreta dentro del ámbito de recursos humanos:

¿Cuántos contratos temporales de cobertura se generan cuando aumenta el absentismo laboral por incapacidad temporal (IT)?

La idea central es construir un modelo de regresión lineal a partir de datos históricos mensuales para estimar la relación entre ambas variables y transformar esa relación en una herramienta sencilla de apoyo a la decisión.

Más que presentar solo un modelo final, este proyecto reproduce el recorrido completo de un proyecto de predicción cuantitativa: desde la formulación del problema hasta su despliegue en una pequeña aplicación web.


1. Definición del objetivo

Todo proyecto predictivo empieza con una pregunta bien formulada. En este caso, el objetivo es estimar el impacto que tiene el aumento del absentismo por IT sobre la necesidad de realizar contratos temporales de cobertura.

Pregunta del proyecto

¿Cómo varía el número de contratos temporales de cobertura cuando aumenta el volumen mensual de IT?

Variable objetivo

  • y = contratos_temporales_cobertura

Variable explicativa principal

  • X = absentismo_IT
  • En la aplicación final, esta variable podrá introducirse como número de nuevas ITs o como el indicador mensual equivalente, según cómo quede definido el dataset definitivo.

Horizonte de análisis

  • Datos históricos con frecuencia mensual
  • Modelo orientado a estimación cuantitativa y simulación de escenarios

Utilidad práctica

Este modelo puede servir como herramienta de apoyo para:

  • anticipar necesidades de contratación temporal,
  • mejorar la planificación de recursos humanos,
  • justificar decisiones organizativas con una base cuantitativa,
  • explorar escenarios de aumento o reducción del absentismo.

2. Adquisición de los datos

El siguiente paso consiste en reunir y documentar la información necesaria para construir el modelo.

En este proyecto se trabaja con un archivo CSV que contiene observaciones mensuales históricas de las dos variables principales:

  • absentismo por IT,
  • contratos temporales de cobertura.

Dataset

Archivo principal:

  • data/absentismo_contratos.csv

Estructura esperada

Cada fila representa un mes del histórico. El dataset incluirá, como mínimo, las siguientes columnas:

  • fecha
  • dias_absentismo_it
  • dias_contratos_cobertura

Ejemplo conceptual:

fecha dias_absentismo_it dias_contratos_cobertura
2021-01 125 18
2021-02 138 21
2021-03 149 24

Nota sobre el origen de los datos

The data included in absentismo_contratos.csv is fictitious.

It has been created for educational and illustrative purposes only. It does not correspond to real institutional or administrative data, although it is structured to resemble a realistic monthly workforce planning dataset.


3. Exploración de la información

Antes de entrenar ningún modelo, es necesario observar los datos y entender qué patrón contienen.

En este proyecto, el análisis exploratorio se desarrolla en el notebook:

  • notebooks/01_data_cleaning_eda.ipynb

Qué se analiza en esta fase

  • estructura general del dataset,
  • tipos de datos y valores faltantes,
  • posibles errores o registros atípicos,
  • distribución de las variables,
  • evolución temporal mensual,
  • relación entre absentismo IT y contratos de cobertura,
  • correlación lineal entre ambas variables.

Objetivo de esta fase

La finalidad del EDA es comprobar si existe una relación suficientemente clara y estable como para justificar el uso de una regresión lineal simple.

En particular, este notebook deberá terminar mostrando que:

  • existe asociación positiva entre ambas variables,
  • la nube de puntos sugiere una tendencia aproximadamente lineal,
  • el problema puede formularse como una estimación de tipo lineal interpretable.

4. Preparación del dataset

Los modelos solo funcionan bien cuando los datos están bien definidos y organizados. Por eso, antes del modelado, se realiza una fase de limpieza y preparación.

Esta fase también queda recogida en:

  • notebooks/01_data_cleaning_eda.ipynb

Tareas de preparación previstas

  • parseo y ordenación de la variable fecha,
  • revisión de duplicados,
  • tratamiento de valores nulos,
  • validación de tipos numéricos,
  • homogeneización de nombres de variables,
  • selección final de las columnas necesarias para modelar.

Dataset final para modelado

El resultado de esta fase es un conjunto de datos limpio, consistente y listo para construir el modelo de regresión.


5. Construcción del modelo

La fase de modelado se desarrolla en el notebook:

  • notebooks/02_modeling.ipynb

Aquí se entrenan y comparan dos enfoques de regresión lineal, evaluándolos con un conjunto de prueba para seleccionar el más útil.

Modelos a comparar

Modelo 1. Regresión lineal con scikit-learn

Modelo orientado a predicción práctica, entrenamiento sencillo y fácil integración posterior en una app.

Modelo 2. Regresión lineal con statsmodels (OLS)

Modelo orientado a interpretación estadística, útil para analizar coeficientes, significación y ajuste global.

Estrategia de evaluación

El notebook dividirá el histórico en:

  • train
  • test

Y comparará ambos enfoques mediante métricas como:

  • MAE
  • RMSE
  • R²

Resultado esperado

Seleccionar el modelo que ofrezca el mejor equilibrio entre:

  • capacidad predictiva,
  • interpretabilidad,
  • facilidad de despliegue.

Interpretación del modelo

Uno de los principales intereses de este proyecto no es solo predecir, sino interpretar el coeficiente de la regresión.

Es decir:

estimar cuántos contratos temporales adicionales se generan, en promedio, por cada incremento unitario del absentismo IT.


6. Despliegue y monitorización

Un modelo adquiere valor real cuando se pone en uso. Por eso, este repositorio incluye una pequeña aplicación web desarrollada con Streamlit para mostrar el modelo en acción.

Archivo principal:

  • app/app.py

Funcionalidad de la aplicación

La app permitirá introducir como dato de entrada:

  • un número de nuevas ITs, o
  • el valor mensual del indicador de absentismo definido en el proyecto,

y devolverá como salida:

  • la estimación de contratos temporales de cobertura esperados.

Objetivo de la app

Transformar el modelo en una herramienta simple, comprensible y reutilizable, pensada para simulación de escenarios.

Monitorización futura

Aunque este repositorio muestra una primera versión funcional, cualquier uso real del modelo exigiría:

  • actualizar periódicamente el dataset,
  • reevaluar el ajuste del modelo,
  • comprobar si la relación entre variables se mantiene estable en el tiempo.

Estructura del repositorio

absentismo-it-contratos-regresion/
│
├── README.md
├── README_ESP.md (readme in spanish)
├── requirements.txt
├── .gitignore
│
├── data/
│   └── absentismo_contratos.csv
│
├── notebooks/
│   ├── 01_data_cleaning_eda.ipynb
│   └── 02_modeling.ipynb
│
├── app/
│   └── app.py
│
└── outputs/
    ├── figures/
    └── model/
Del absentismo a la contratación temporal: un proyecto de regresión lineal simple paso a paso

A menudo se habla de predicción cuantitativa como si fuera un terreno reservado a modelos complejos, librerías sofisticadas y sistemas difíciles de explicar. Pero no siempre hace falta empezar por ahí. De hecho, muchas veces creo que ocurre lo contrario: para entender bien qué significa predecir con datos, conviene empezar por un modelo pequeño, transparente y fácil de interpretar.

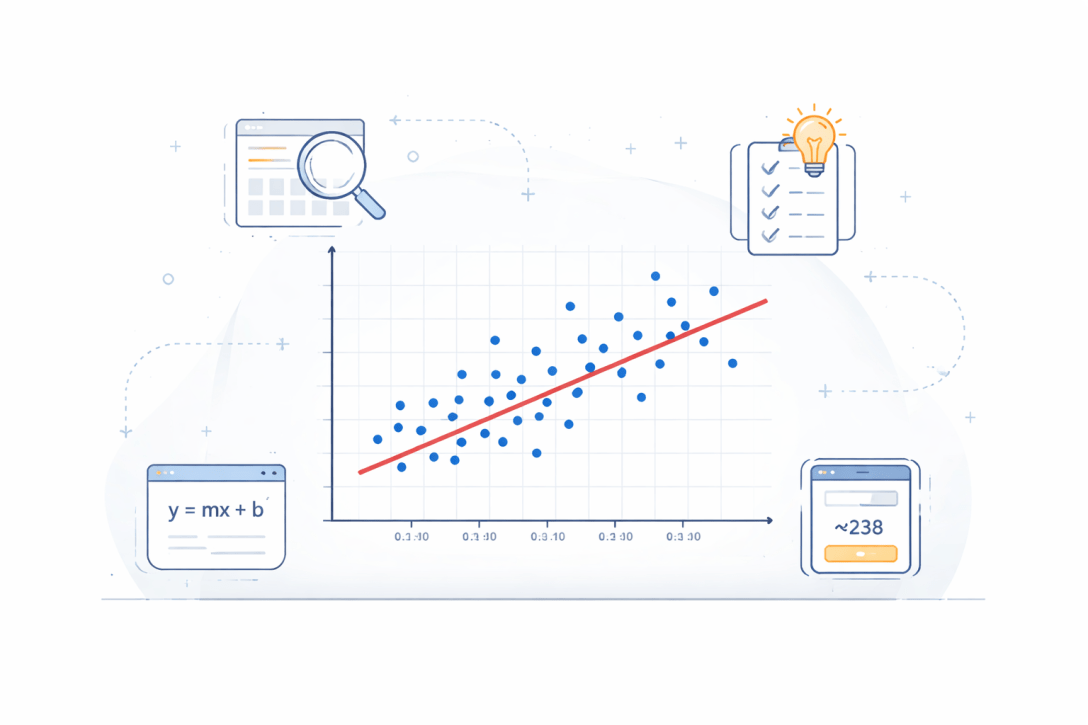
Por eso he querido compartir en GitHub un proyecto completo construido alrededor de una pregunta muy concreta: cómo estimar cuántos días de contratos temporales de cobertura pueden generarse cuando aumenta el absentismo laboral por incapacidad temporal (IT). No he preparado este repositorio para presentar un gran sistema productivo ni una solución definitiva. Lo he hecho para mostrar, de forma reproducible, cómo puede utilizarse una regresión lineal simple como método de predicción cuantitativa.

La idea del proyecto no es solo enseñar una ecuación. Es enseñar un recorrido. Cómo se parte de una pregunta real, cómo se traduce esa pregunta a variables medibles, cómo se preparan los datos, cómo se comprueba si la relación tiene sentido y cómo se convierte finalmente el modelo en una pequeña aplicación utilizable. En el fondo, lo que me interesaba compartir no era solo el resultado, sino el proceso.

Seguir leyendo «Del absentismo a la contratación temporal: un proyecto de regresión lineal simple paso a paso»

La regresión lineal simple: el primer puente entre datos y predicción

En muchos contextos cotidianos observamos relaciones entre variables: más horas de estudio suelen asociarse con mejores notas, viviendas más grandes suelen tener precios más altos, y más entrenamiento suele mejorar el rendimiento deportivo.

La pregunta que surge de forma natural es sencilla pero profunda: ¿podemos cuantificar estas relaciones para anticipar lo que ocurrirá en el futuro?

Uno de los modelos más simples y elegantes para responder a esta pregunta es la regresión lineal simple. A pesar de su aparente sencillez, este modelo constituye uno de los pilares fundamentales de la predicción cuantitativa.

Seguir leyendo «La regresión lineal simple: el primer puente entre datos y predicción»

Historia de la regresión: de la regla de tres al machine learning

Cuando hoy escuchamos palabras como machine learning o inteligencia artificial, es fácil imaginar algoritmos sofisticados trabajando sobre enormes bases de datos. Sin embargo, la idea fundamental detrás de muchos de estos modelos es mucho más antigua. En el fondo, todos intentan responder una pregunta sencilla: si una variable cambia, cómo cambia otra.

Responder a esa pregunta con números ha sido una preocupación constante durante siglos. Mucho antes de que existiera la estadística formal, científicos, comerciantes y astrónomos ya intentaban encontrar patrones que permitieran anticipar resultados.

La regresión moderna es el resultado de ese largo esfuerzo intelectual. Su historia no es una ruptura tecnológica reciente, sino una evolución gradual de ideas que comienzan con cálculos muy simples y terminan en los algoritmos de aprendizaje automático actuales.

1. Cuando predecir era hacer cuentas

Seguir leyendo «Historia de la regresión: de la regla de tres al machine learning»

De la pregunta a la predicción: cómo se construye un modelo cuantitativo

Cuando se habla de inteligencia artificial o aprendizaje automático, muchas veces se piensa inmediatamente en algoritmos complejos. Sin embargo, en la práctica los modelos son solo una pequeña parte del trabajo.

La predicción cuantitativa no consiste simplemente en “aplicar un algoritmo”. Consiste en recorrer un proceso estructurado que transforma datos en conocimiento útil para tomar decisiones.

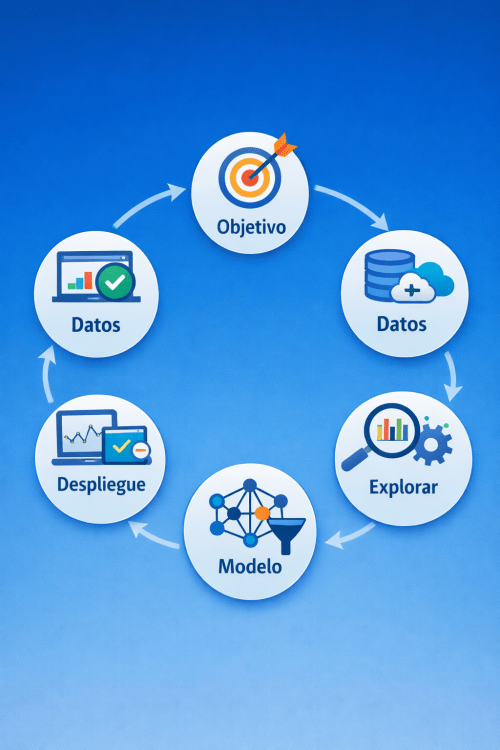
Ese proceso es lo que en ciencia de datos se conoce como el ciclo de vida de un proyecto de Machine Learning.

Aunque los modelos puedan ser muy diferentes —desde una simple regresión hasta sistemas avanzados de deep learning—, casi todos los proyectos siguen una lógica muy similar.

En términos generales, este recorrido puede resumirse en seis etapas:

  1. Definir el objetivo
  2. Adquirir los datos
  3. Explorar la información
  4. Preparar el dataset
  5. Construir el modelo
  6. Desplegar y monitorizar

En este post veremos brevemente qué ocurre en cada una de estas fases. En futuras publicaciones iré mostrando proyectos reales que siguen exactamente esta misma estructura. Estos nos servirán de ejemplo de los modelos de predicción cuantitativa más utilizados

Seguir leyendo «De la pregunta a la predicción: cómo se construye un modelo cuantitativo»

El Método Delphi: cuando la predicción cualitativa se vuelve estructurada

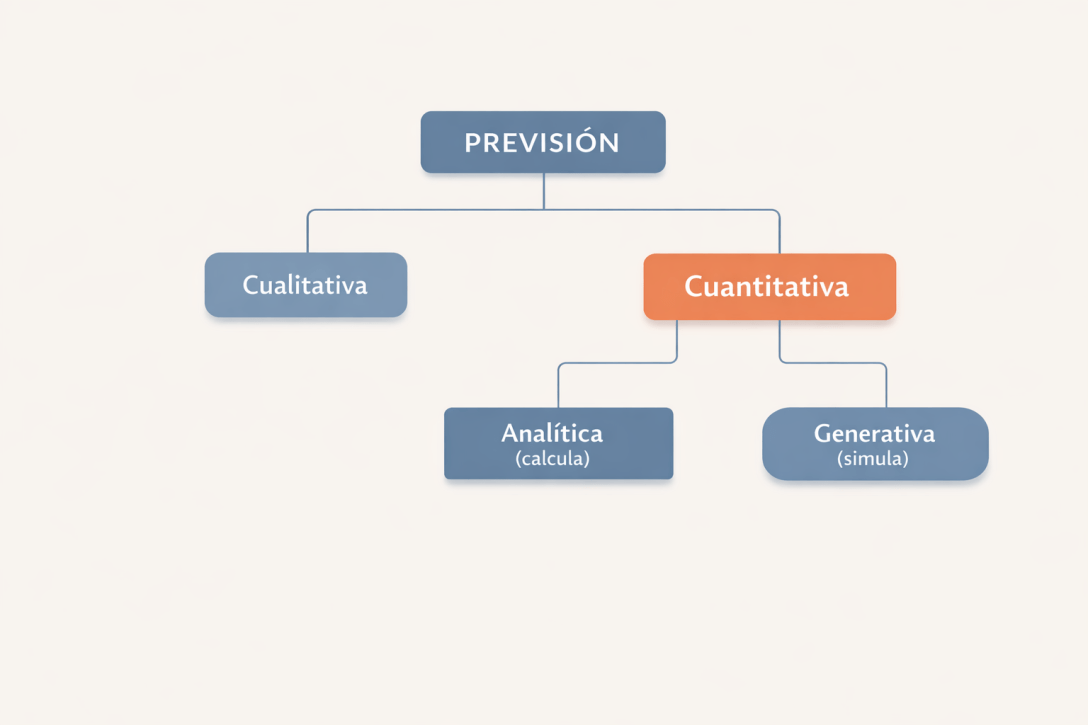
En un post anterior clasificábamos los métodos de previsión en dos grandes familias: cuantitativos y cualitativos. Dentro de los cualitativos podemos distinguir aquellos basados en juicio individual (opinión experta, analogías históricas, escenarios narrativos) y aquellos que intentan estructurar el juicio colectivo para reducir sesgos. El método Delphi pertene a esta segunda categoria.

No es predicción basada en datos en sentido estricto porque no parte de series temporales ni modelos matemático pero tampo es simple intuición. Es, probablemente, el intento más sofisticado del siglo XX de convertir el juicio experto en una herramienta sistemática de predicción.

Este método nació además en un contexto donde equivocarse podía significar una guerra nuclear.

Seguir leyendo «El Método Delphi: cuando la predicción cualitativa se vuelve estructurada»

Predicción cuantitativa por simulación: cuando proyectar no basta y necesitamos recrear el sistema

En el post anterior vimos cómo la predicción cuantitativa analítica parte de una estructura estimada y la proyecta hacia el futuro. Funciona especialmente bien cuando el fenómeno es relativamente estable y las relaciones pueden formalizarse mediante una ecuación o función. Pero no todos los sistemas se comportan así.

Hay contextos donde:

  • Las interacciones entre elementos generan dinámicas emergentes.
  • La incertidumbre es central y acumulativa.
  • Los resultados no dependen de una única trayectoria, sino de muchas posibles.
  • El comportamiento futuro depende de decisiones que se retroalimentan.

En estos casos, en lugar de resolver un modelo, necesitamos simular un sistema. Eso nos lleva a la segunda gran familia de la predicción cuantitativa: la predicción basada en simulación.

Seguir leyendo «Predicción cuantitativa por simulación: cuando proyectar no basta y necesitamos recrear el sistema»

Predicción cuantitativa analítica: cuándo usarla y cómo elegir modelo

En el post anterior vimos que la predicción no siempre empieza con datos y modelos: a veces lo más razonable es recurrir a estrategias cualitativas. Pero cuando el fenómeno es lo bastante estable, repetible y medible, la predicción cuantitativa ofrece algo muy valioso: un lenguaje común para comparar, evaluar y mejorar.

Ahora bien, dentro de la predicción cuantitativa conviene hacer una distinción fundamental porque no todos los modelos numéricos funcionan igual.

  • Algunos resuelven una estructura matemática estimada a partir de los datos y producen una predicción directa.
  • Otros, en cambio, recrean el sistema múltiples veces mediante simulación, generando dinámicas posibles y distribuciones emergentes.

Este post se centra en la primera familia: la predicción cuantitativa analítica.

Seguir leyendo «Predicción cuantitativa analítica: cuándo usarla y cómo elegir modelo»

Predicciones cualitativas: cómo predecir antes de cuantificar

Cuando se habla de predicción, la conversación suele girar rápidamente hacia modelos cuantitativos, datos y algoritmos. Sin embargo, en muchos contextos reales, la mejor estrategia predictiva no es cuantitativa, ni tampoco una simulación formal.

Antes de números, a menudo solo hay experiencia, analogías, narrativas plausibles y/o juicios informados.

A eso lo llamamos predicción cualitativa y lejos de ser un recurso “menor”, es una estrategia legítima y, en muchos casos, necesaria.

1. ¿Cuándo conviene usar predicción cualitativa?

La predicción cualitativa es especialmente útil cuando forzar una predicción cuantitativa sería artificial o engañoso. No siempre faltan datos; a veces lo que falta es estructura, comparabilidad o estabilidad.

Hay cuatro situaciones típicas:

Seguir leyendo «Predicciones cualitativas: cómo predecir antes de cuantificar»

Un mapa de las estrategias de predicción

Hablar de predicción suele llevarnos demasiado rápido a los modelos: regresión, clasificación, redes neuronales, machine learning. Pero empezar por ahí es como aprender geografía memorizando capitales sin haber visto nunca un mapa.

Antes de entrar en técnicas concretas, algoritmos o librerías, conviene dar un paso atrás y responder a una pregunta más básica:

¿De cuántas formas distintas intentamos predecir el futuro?

Este post es el primero de una serie extensa dedicada a recorrer, con calma, las distintas estrategias de predicción. No empieza por el cómo se calcula, sino por el cómo se piensa un problema predictivo.

La imagen que encabeza este post resume ese mapa general. A lo largo de la serie volveremos a ella muchas veces.

Seguir leyendo «Un mapa de las estrategias de predicción»